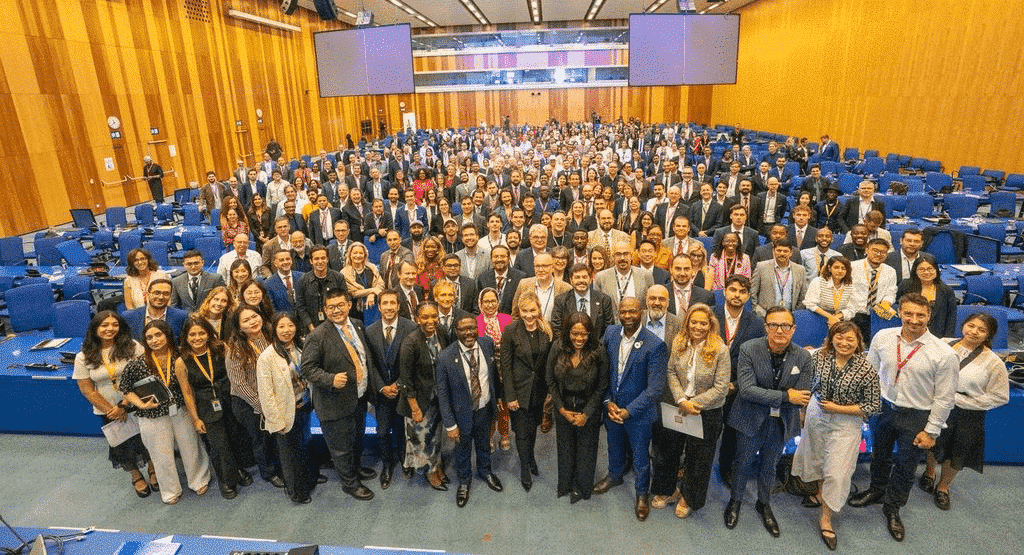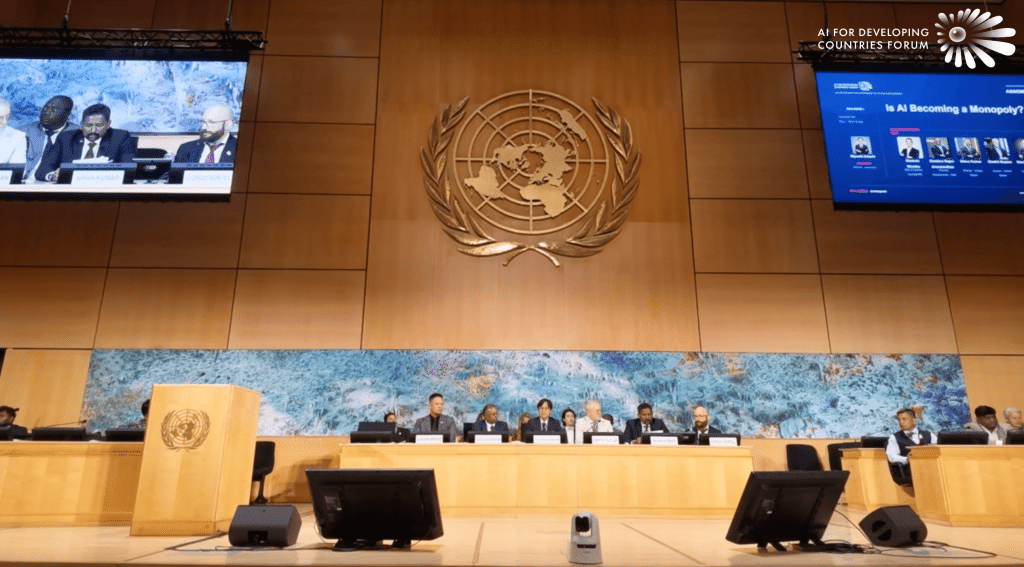
本网站主办方发展中国家人工智能论坛(AIFOD)于2026年8月举办了2026年AIFOD日内瓦峰会,旨在审视塑造国际人工智能格局的关键张力。
在由联合国贸发会议(UNCTAD)法律官员Kiyoshi Adachi主持的对话一“人工智能是否正在走向垄断?”中,与会嘉宾就市场力量正在何处积聚展开了辩论。Sundara Rajan Aravamuthan指出,价值探讨必须承认训练模型的数据工作者所付出的关键劳动。Dimitri Boylan认为,市场主导地位可能并不取决于前沿模型,并提出中间软件层可以使企业能够使用多家供应商的服务,从而避免供应商锁定。Shiva Kumar警告称,如果底层基础设施依然遥不可及,开源代码并不能保证可及性。尽管Giorgio Bartoli提出较小国家可以构建本地化、目标导向的系统,但Gladwin Mendez告诫不要退而求其次选择性能较弱的技术,并倡导政府应独立于技术供应商。
对话十二“在人工智能领域,规模是否总是越大越好?”分析了参数规模是否应继续作为衡量进步的标准指标。Bruce Mellado教授分享了南非空气质量监测的工作,表明更先进的系统在严格受限于特定任务时表现良好,不过较小的模型同样可以产生有用的结果。Marisa Boller建议根据社会影响来评估能耗和水资源消耗,例如利用人工智能来防止供水管网泄漏。Muhammad Jawad Ali指出,本地部署的小型模型有助于面临高昂云计算成本的小微企业,而Elżbieta Deja观察到,本地训练的模型能够保留大型通用翻译器所忽略的文化细微差异。Pascal Hetzscholdt谈及了问责问题,指出在系统出错时,模型的分布式部署会使法律责任的认定复杂化。
对话十五“由谁决定哪款人工智能更优秀?”对传统测试标准提出了质疑。主持人Raja Gopalan Balasubramnyan指出,基准测试反映了人类在数据和代表性方面的选择,而Fabrizio Degni则强调,糟糕的数据治理会使基准评分失去效力。Rui Alexandre Castanho建议从性能、语境和影响三个维度来评估系统。与单纯的模型评分相比,Frederick Tschernutter主张衡量其对人类的实用性,并警告称机器的进步绝不能侵蚀个体的能动性。法律从业者Peter Ruggle建议追问测试的资助方是谁,以及供应商是否会在合同中为其基准测试的主张提供担保。与会嘉宾一致认为,一个评分为90%但符合本地语言和隐私需求的模型,往往优于不适用的95%系统。
在由Nobu Ota主持的对话十一“小国能否在人工智能领域形成合力?”中,与会代表探讨了较小国家之间的协调机制。Sven Soomuste参考了爱沙尼亚的数字国家建设,建议各国在部署人工智能之前先培养人才能力。Tan James Anthony鼓励较小经济体利用自身独特的专有数据集,而Sönke Lund坚称,形成集体影响力需要共享的监管和采购框架。Ruth Gafni强调了通过跨境教育合作来增进伦理理解。
核心要点
- 与会嘉宾指出,如果没有普及的硬件基础设施,开源代码就无法真正实现人工智能的平民化。
- 实际案例研究表明,在解决本地问题方面,专用型定制模型的表现往往优于更庞大的通用系统。
- 与会代表摒弃了唯原始基准评分论,呼吁采用能够评估数据谱系、本地适用性以及对人类实用性的综合指标。
- 发言嘉宾得出结论,较小国家如果能建立通用标准和谈判机制,则无需推行完全一致的政策。
- 与会者一致认为,提升人类能动性、批判性思维和机构问责制,必须优先于追求技术演进的速度。